私は将棋AIの開発にLeanを活用している。今回は、その話を詳しく書く。
■ 将棋AIに使われている二つの難解なアルゴリズム
将棋AIには、特に難解なアルゴリズムが2つある。df-pnとペタショック化アルゴリズムである。
df-pnは、長手数の詰め将棋を解くアルゴリズムだ。詳しくは、以前、このブログで記事にまとめたので、そちらをご覧いただこう。
ペタショック化アルゴリズムは、私が自動生成している超巨大定跡「新ペタショック定跡」で使われている。
ここでは、このアルゴリズムについて詳しく書く。
■ ペタショック化とは?
ペタショック化とは、簡単に言うと定跡DB上の各局面で、minimax探索をした結果をその局面の評価値とするような変換である。
こうすることで、各局面で、自分の手番から見て最善の評価値となる指し手を選択し続ければ、定跡DB上の最善の進行となることが保証される。
ところが、minimax探索するとは言っても、将棋の定跡は、角換りでは特に手待ちのために分岐と合流を繰り返すので、単純なminimax探索だと容易に組み合わせ爆発が起きてしまうのである。
メモ化すればいいんじゃないか?と言われるかもしれないが、千日手(引き分け)や連続王手の千日手(反則手)のような循環が含まれるのでメモ化では解決しない。
普通、こういうのは後退解析を用いるのだが、ループがある場合、後退解析は一筋縄ではいかない。
また、ある局面で評価値が同じ指し手A,Bがあるとき、Aを選ぶとこの局面に戻ってきてしまうことがある。Bを選ぶと千日手にならずにループを抜けるとする。Aを選んで元の局面に戻ってきてもそこでBを指せばループから抜けられるから、この局面のA,Bの指し手の評価値は同じになるが、Aを選び続けると千日手になるから、千日手にならない手順を選びたいならこの局面ではBを指さないといけない。
このように、評価値が同じ指し手のなかにも、ループから抜けられる手と、ループを繰り返してしまう手がある。したがって、単に評価値を整合させるだけでは不十分で、ループからの脱出を保証する仕組みが必要となる。
ペタショック化アルゴリズムは、これらの問題をいくつかの魔法じみた方法により解決している。
■ ペタショック化アルゴリズムが生み出されるまで
ここで、ペタショック化アルゴリズムが誕生するに至った経緯を詳しく書きたい。
それは、私が数年前にAtCoderという競技プログラミングのサイトに少しだけ参加していた時のことだ。
当時、将棋の巨大定跡を作るには、定跡DBをminimax化する変換(ここで言う「ペタショック化」)が必要であると私は認識していた。
競技プログラミングが、そのようなアルゴリズムを開発するうえで参考になるのではないかと思い、勉強がてらAtCoderに参加してみたのだ。
AtCoderは、初参加時に1500パフォぐらい出たものの、AtCoderには数学的な考察力を要求する問題が多く、その部分が比較的弱い自分は、このまま1年ぐらいやり続けても、せいぜいレート2400ぐらいが限界だと思った。
もっと数学と真摯に向き合い、数学的な基礎力自体を伸ばせばレートはもっと伸ばせるかもしれないが、それを競技プログラミングの文脈でやるべきことだとは思わない。だから、競技プログラミング自体は3ヶ月ほどでやめてしまった。(その3ヶ月は、毎日が楽しく、1日16時間ぐらいやっていたし、その経験はとても得がたいものだったとだけ書いておく。)
当時、ChatGPTなどがまだない時代だったので、私の実力をそのまま記録に残せたのはよかったと思っている。いまAtCoderで初参加で高い成績を出しても、「お前、ChatGPT使ったな?」とか言われかねんしな。
競技プログラミングの勉強中に、出てきたワードで検索するとQiitaの記事がヒットすることがあって、とてもわかりやすく洞察に長けた内容が書かれていることが多々あった。「これ書いた人はとても頭のいい人だな」などと記事を熟読すると、記事の投稿者は決まって「けんちょん」だった。
けんちょんさんの記事からは、内容そのものはもちろん、文章の書き方、図の描き方、用語の選び方に至るまで、多くのことを学ばせてもらった。
ゲームを解く!Educational DP Contest K, L 問題の解説
https://qiita.com/drken/items/4e1bcf8413af16cb62da
毎日AtCoderの問題に取り組んでいるうちに、脳が活性化したのだろうか。ある日、上のけんちょんさんの記事を読んでいるとき、ふと閃いたのである。
将棋の定跡をminimax化するには、末端の評価値を、動的計画法に出てくるベルマン方程式に従って親局面へ伝播すればよいのではないか。
この伝播を繰り返していくと、各局面の評価値が互いに整合する状態に到達する。つまり、評価値を更新しても値が変わらない「不動点」を求めればよいのである。
その後、その考えをさらに発展させ、千日手や連続王手の千日手への対応、さらにはループからの脱出保証まで実現できるアルゴリズムに改良した。(このアルゴリズムは、のちにペタショック化アルゴリズムと呼ばれることになる。)
実際、それをPythonで実装してみたところ、正しく動いた。それまでは容易に組み合わせ爆発が起き、何日かけても計算が終わらなかった。それが、O(V+E)、つまり局面数と指し手の数の和に比例する程度の計算時間で求められるようになった。
ただ、そのアルゴリズムの正しさを自分自身では証明できていなかった。
私は計算幾何学の専門家でもないので、生涯かけてもこのアルゴリズムの正しさを証明することはできないだろうと諦めていた。
正しさを証明できない以上、画期的なアルゴリズムを考案したなどと発表するのもどこか躊躇われた。
この画期的なアルゴリズムには、ただ実装だけが存在し、巨大定跡を掘るためにひっそりと使われていたのである。
■ Leanで証明された43の定理
それが先日、Xで「テレビ見ながら、ChatGPTに数学の未解決問題を与えたら、解けたみたい」というような投稿が流れてきた。
本当かどうかは知らんが、それで解けるなら、私もCodexにやらせたらLeanで証明を書けるんでないか?と思い、$200/月プランでリセット権が3回分余っていたのでそれ全部ぶっぱなして、Codex(使用したモデルは、GPT-6 Astra)でLeanでの証明を書かせた。
二晩ほどかけて、最終的に43の定理と、それらを証明する5万行ものLeanコードができあがった。
おまけに、元のアルゴリズムのコーナーケースで発生する実装上の欠陥まで指摘し、C++のコードを修正してくれた。それだけでなく、アルゴリズムを数学的に定式化し、その正しさをLeanで形式的に証明し、さらに論文のようなものまで書いてくれた。
その論文やLeanによる証明などを一式、下記のリポジトリで公開しておく。正直、内容はなにひとつわからん。読む気にもならん。だが、それでいい。Codexが修正してくれたペタショック化アルゴリズムは、正しく動作し、その実装は、いまも将棋の超巨大定跡を掘るために使われ続けているのだから…。
ペタショック化のアルゴリズムと形式証明
https://github.com/yaneurao/peta-shock
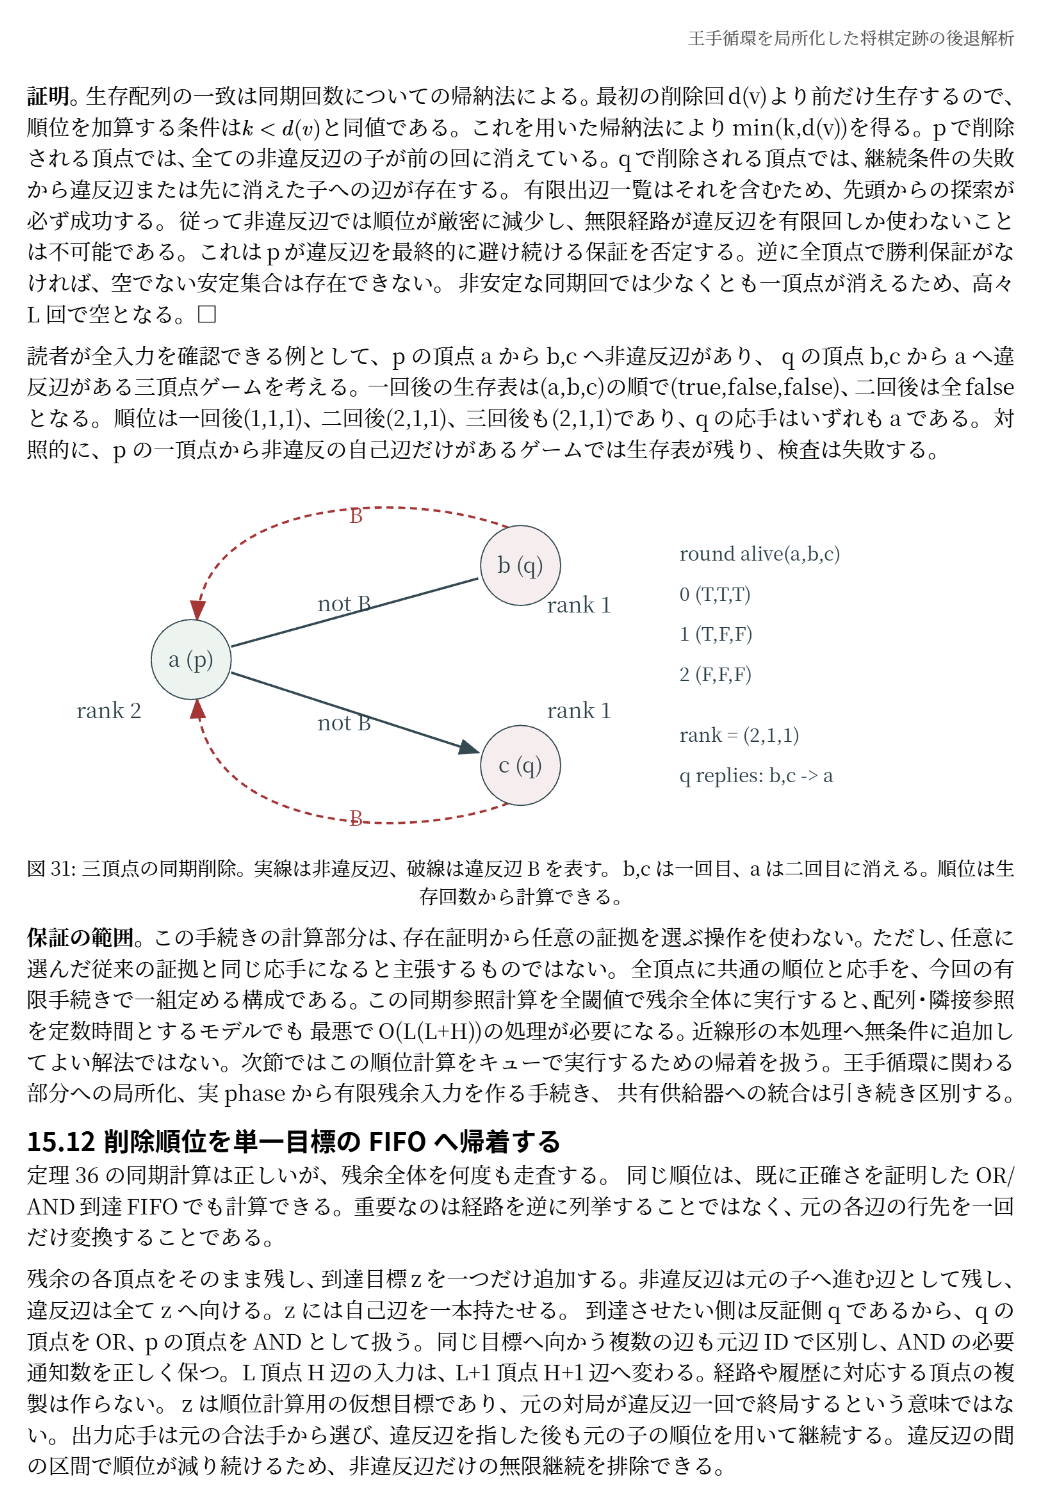
以下は、Codexの書いてくれた論文風の説明の一部。上のリポジトリからその全文をダウンロードできる。全91ページ。
これを見た将棋AI開発者「ぜんぜんわからない。俺たちは雰囲気で将棋AIを作っている…」
■ 超巨大定跡「新ペタショック定跡」について
やねうら王のFANBOXで支援者向けのNews Letterにて頒布しています。(2026年11月6日現在、2100万局面時点のものを頒布。毎月200万局面ずつ追加)
興味のある方は、本ブログの右上あたりにあるバナー「やねうら王プロジェクトを支援する」よりどぞー。